PostgreSQL
hare-orm против SQLAlchemy, tortoise-orm, yara-orm и Django на PostgreSQL: 50 сценариев, таблица из 1 000 виджетов, у каждого — гаджет, метка и документ JSON, и параллельная нагрузка. Чем короче столбец, тем быстрее; исключение — нагрузка, где считаются операции в секунду.
Сводка
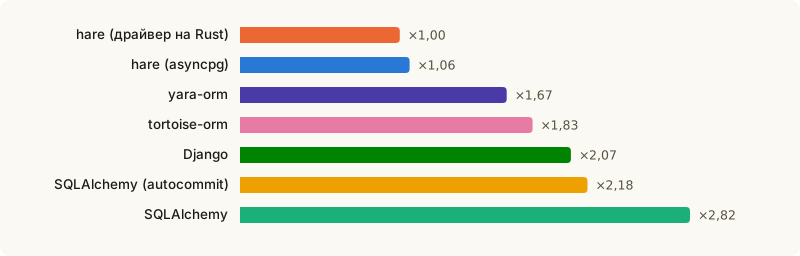
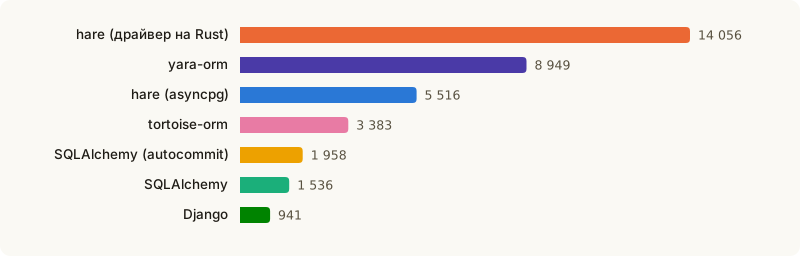
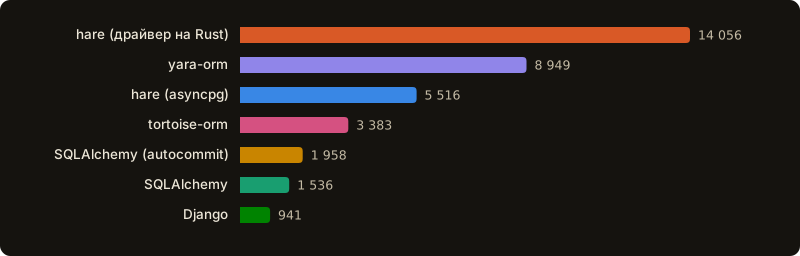
Во сколько раз каждая библиотека в среднем медленнее, чем hare-orm на драйвере на Rust (более быстром драйвере hare-orm в этом прогоне): отношение средних геометрических времени по всем сценариям, которые выполняют обе, кроме запуска.
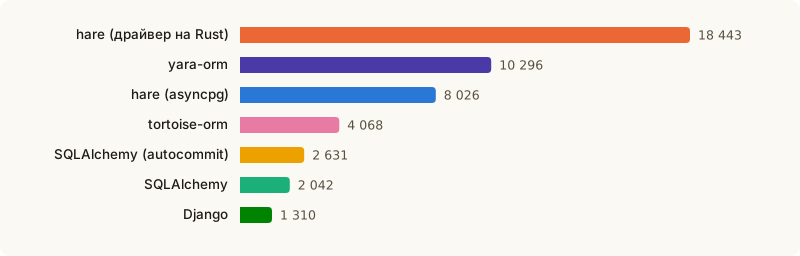
Нагрузка: 50 задач выполняют 1 000 операций на одном пуле подключений: 80% — get(), 15% — чтение с
фильтром, 5% — get() + save(); в нагрузке с записью половина операций — get() + save().
Замер «на горячую»: до начала замера каждое подключение пула выполняет каждую операцию нагрузки, как
в уже работающем приложении.
Операций в секунду:
Операций в секунду, нагрузка с записью:
По сценариям
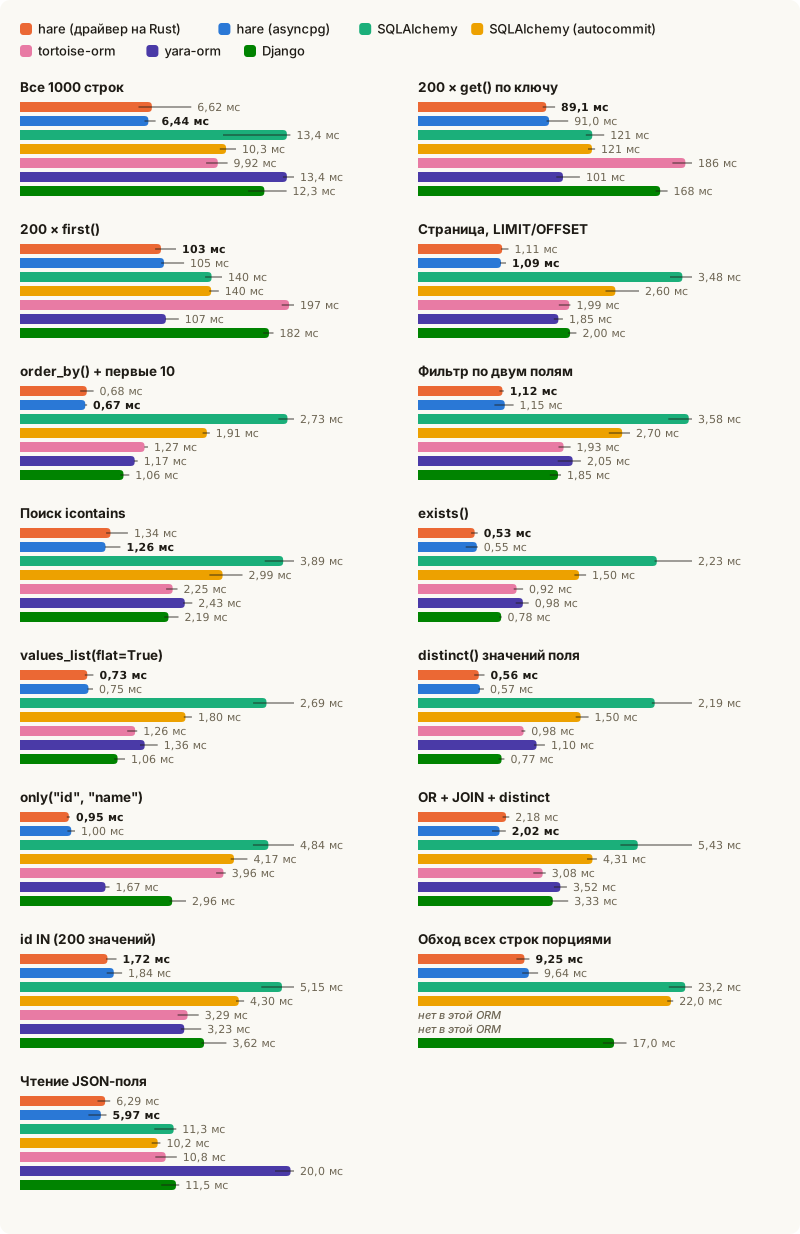
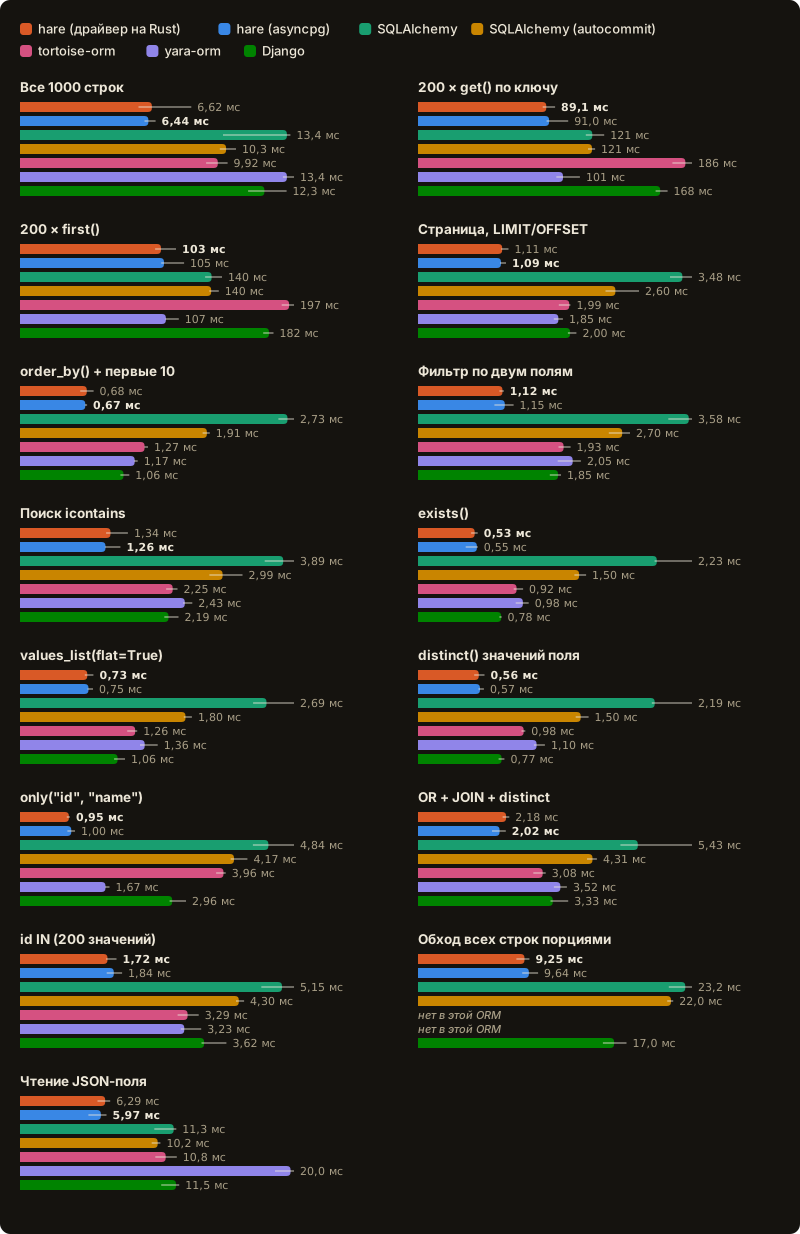
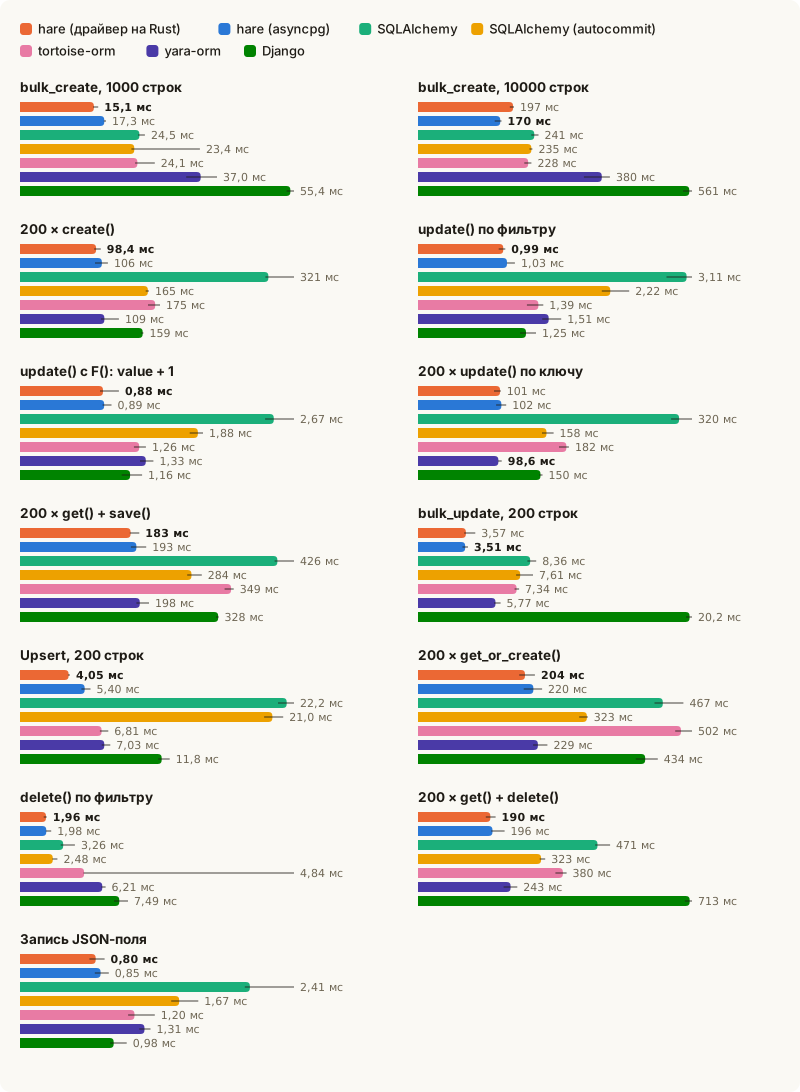
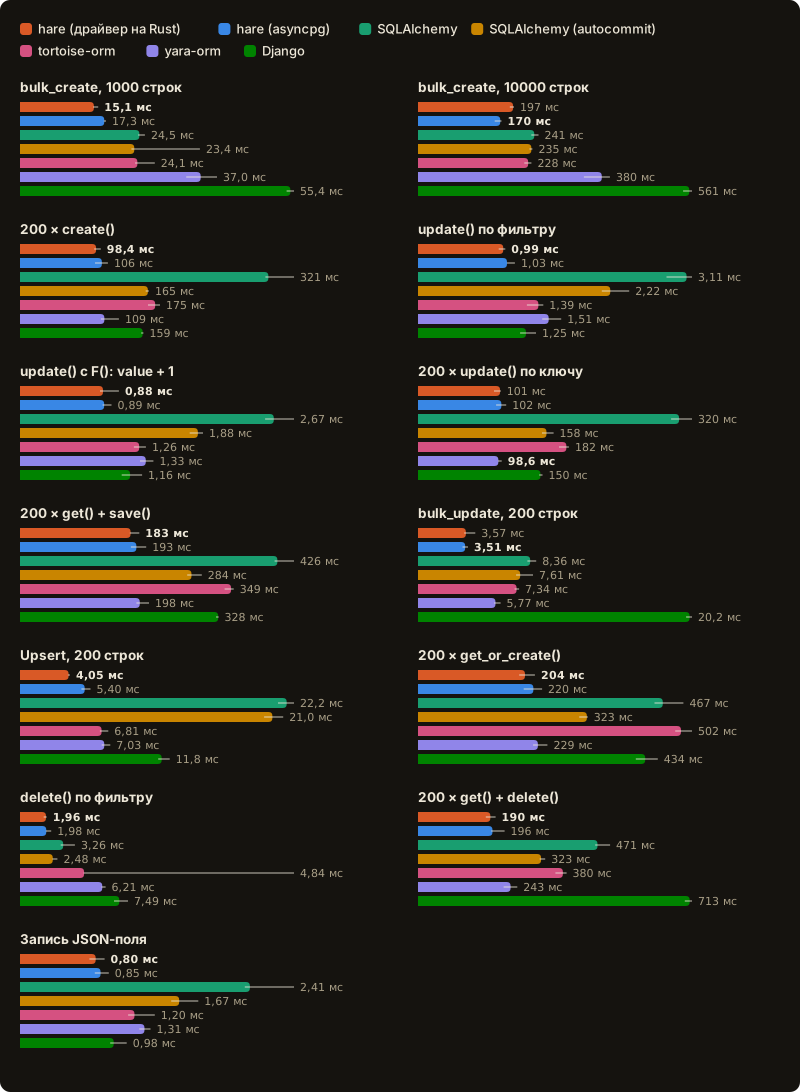
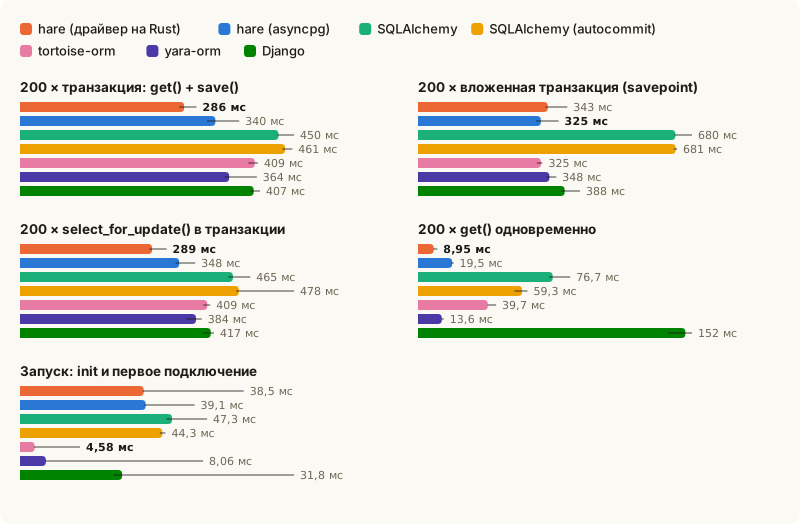
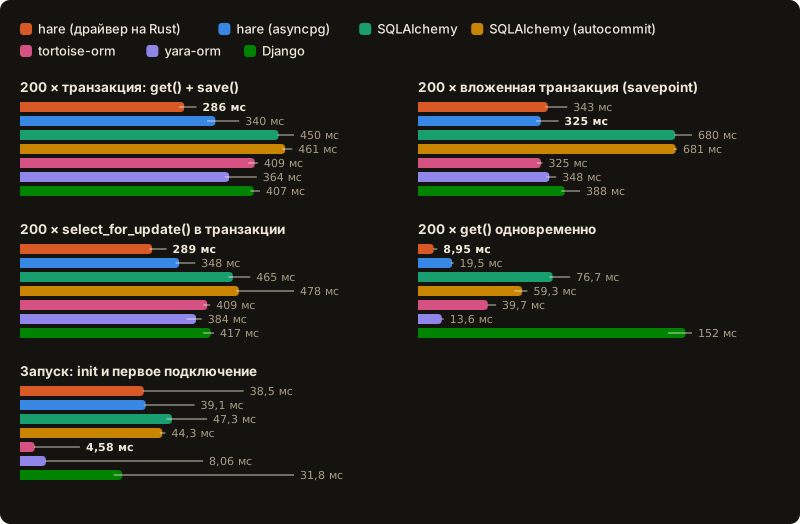
У каждого сценария своя шкала: сравнивайте столбцы внутри одного сценария, а не между сценариями. Лучшее время выделено жирным. Столбец — медиана 5 прогонов, тонкая линия поверх него — разброс от лучшего прогона к худшему.
Чтение
Связи
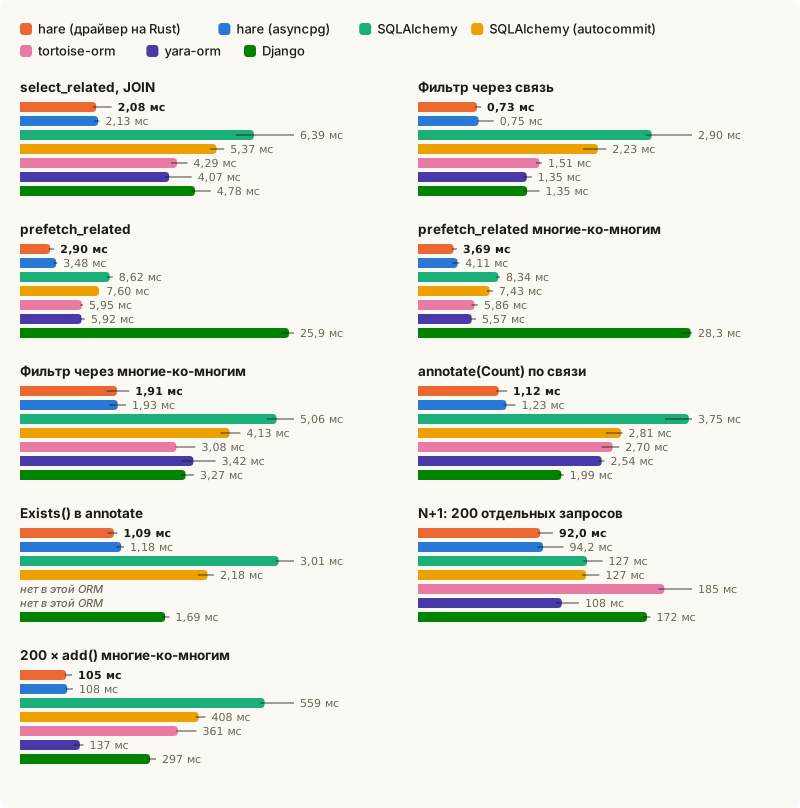
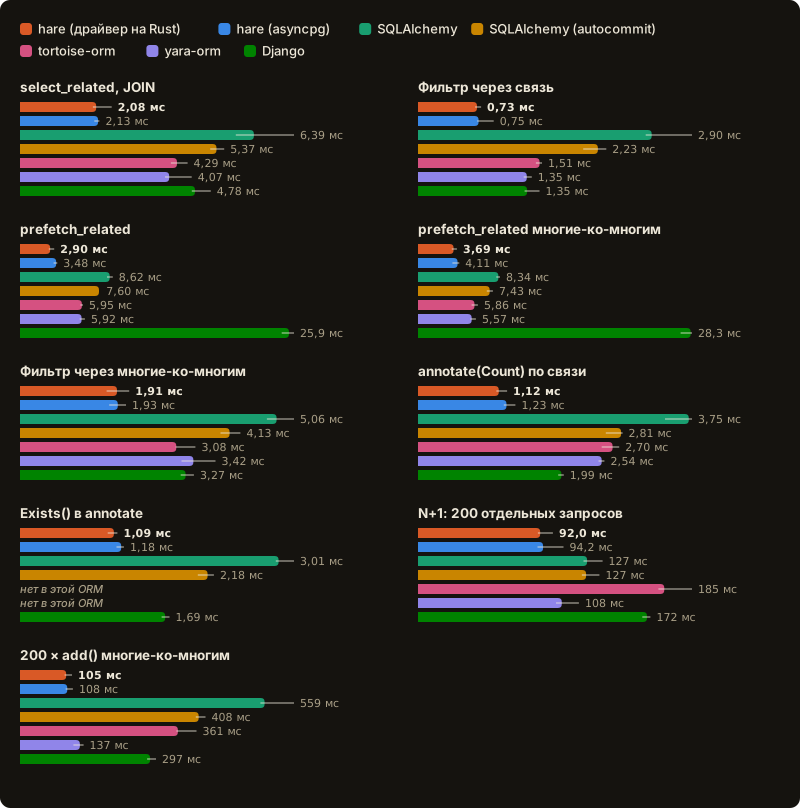
Агрегаты
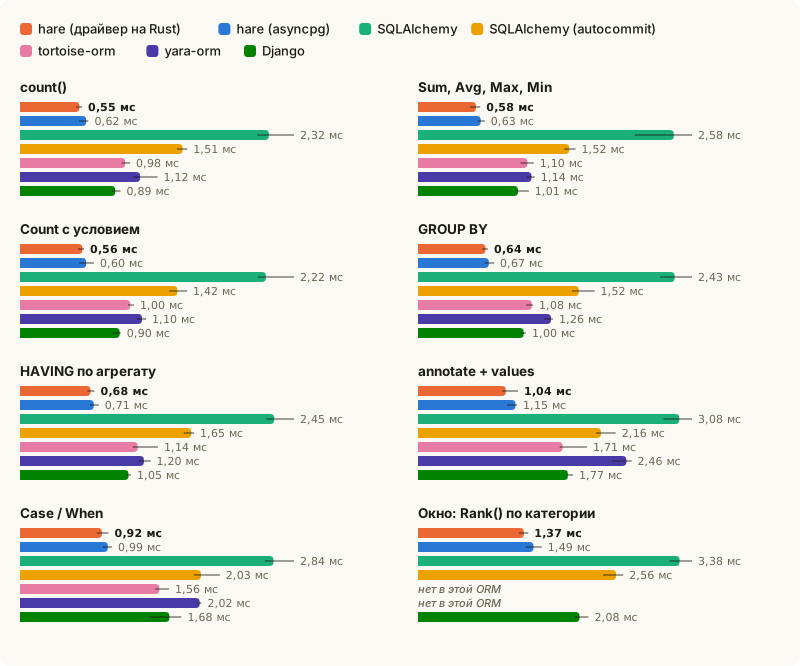
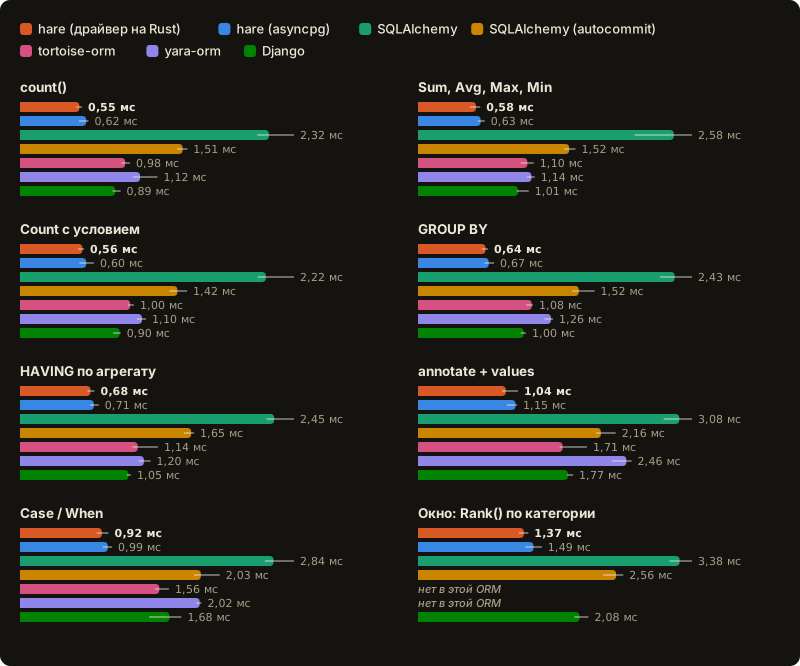
Запись
Транзакции, параллельность, запуск
Где и как измерялось
| Дата | 2026-10-30 |
| Машина | Windows 11, 13th Gen Intel(R) Core(TM) i5-13400, 16 CPU |
| Python | 3.14.3 |
| Релиз hare-orm | 0.12.0 |
| Прогонов | 5, медиана |
| PostgreSQL | 18.6 (Debian 18.6-1.pgdg13+2) |
| asyncpg | 0.31.0 |
| psycopg | 3.3.6 |
| hare-orm | 0.12.0 |
| SQLAlchemy | 2.1.1 |
| tortoise-orm | 1.1.8 |
| yara-orm | 1.17.0 |
| Django | 6.1.1 |
| Строк в таблице | 1 000 |
- На PostgreSQL у каждой ORM пул из 50 подключений; все они открываются до начала замеров.
- На PostgreSQL перед каждой группой сценариев и каждым нагрузочным тестом все таблицы вне замера
проходят
VACUUM (FULL, ANALYZE), а autovacuum для них выключен: каждая группа начинается с компактных таблиц. Иначе мёртвые строки, оставленные записями, убирает autovacuum в случайный момент прогона, и от того, успел ли он, зависит план запроса — с параллельным сканированием или без. - Перед нагрузочным тестом каждое подключение пула вне замера выполняет каждую операцию нагрузки: замер показывает работающее приложение, а не только что запущенное, — подключение уже открыто и подготовило свои запросы.
- Внутри прогона сценарий повторяется 3–5 раз, и в зачёт идёт самый быстрый повтор; строки, которые
пишет сценарий записи, удаляются перед каждым повтором вне замера. Удаления и
add()многие-ко-многим меняют данные безвозвратно и выполняются один раз. - Каждая ORM работает в отдельном процессе. Прогоны идут по кругу, в каждом круге ORM запускаются в случайном порядке; результат сценария — медиана по прогонам.
- На Windows процесс прогона отключает себе энергосбережение (EcoQoS): иначе планировщик может перенести процесс без окна на энергоэффективные ядра гибридного процессора, где он работает вдвое медленнее.
- SQLAlchemy на PostgreSQL и SQLite измеряется дважды: с транзакцией вокруг каждой сессии (её поведение по умолчанию) и с движком в режиме autocommit, где каждая команда фиксируется сразу, как в hare и Django.
- Сценарий, которого в ORM нет, помечен на графике «нет в этой ORM» и не входит в её среднее.
- Запуск — это инициализация библиотеки и её первый запрос; библиотека к этому моменту уже импортирована. В среднее запуск не входит.
- На SQLite каждая ORM работает с одним файлом так, как работает по умолчанию; подключения
SQLAlchemy ждут блокировку записи файла до 30 с вместо 5 с по умолчанию — иначе нагрузка с записью
у её пула из пяти подключений обрывается ошибкой «database is locked».
select_for_update()на SQLite не измеряется: блокировок строк в нём нет. - Таблицу ClickHouse заполняет сам сервер перед сценариями; мутация (
update(),delete()) в каждой библиотеке завершается до возврата из вызова. SQLAlchemy работает через clickhouse-sqlalchemy 0.3.2 с драйвером asynch 0.2.5 на SQLAlchemy 2.0.30 и Python 3.12 — на более новых версиях её асинхронный драйвер не запускается. - Каждый сценарий написан так, как его пишет документация этой ORM.
Стенд — benchmarks/bench.py
в репозитории; в его
README перечислены все
сценарии и описано, как повторить замер на своей машине.